
OpenAI 一夜甩出722篇数学手稿,第二天栽在一个正负号上
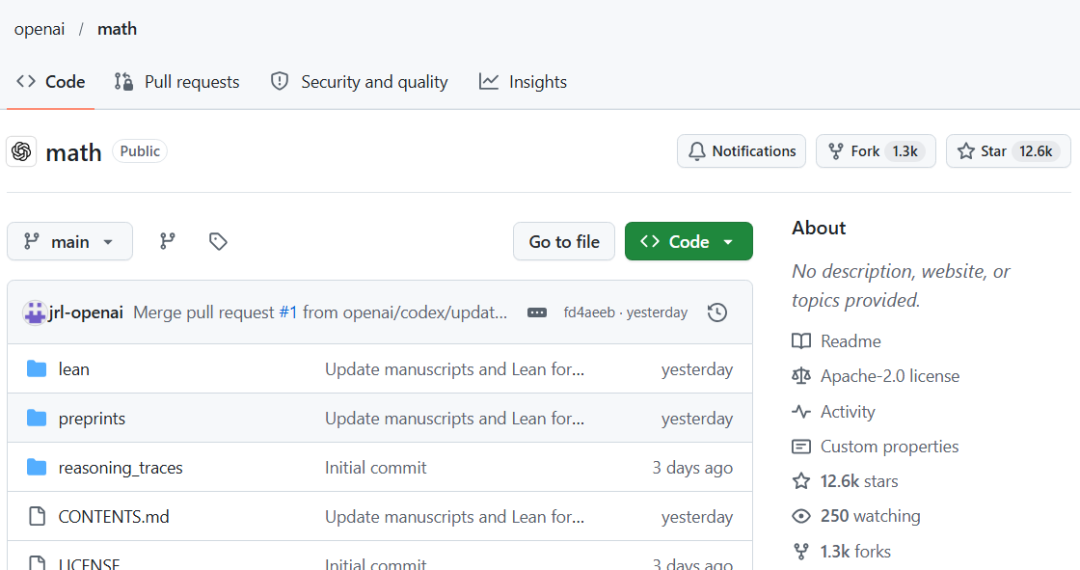
10月6日,OpenAI往GitHub上扔了一个仓库。
722篇数学手稿,全部由AI生成,按372个"问题家族"分类,Apache-2.0协议,随便下。
上线不到24小时,撤了3篇。
撤稿理由说出来有点哭笑不得:一个正负号,写反了。两天之内,这个仓库涨到12.5k star。
先说这三篇是怎么死的
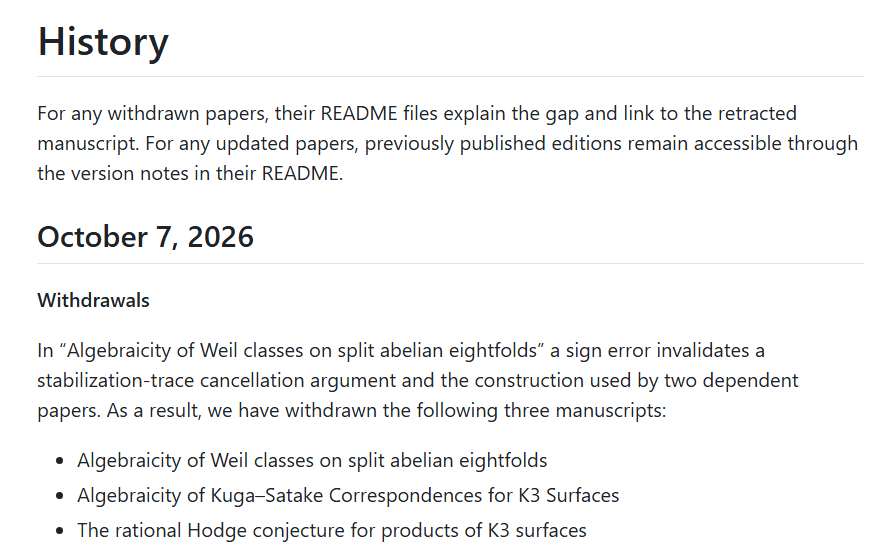
出错的手稿名字很长,叫《Algebraicity of Weil classes on split abelian eightfolds》。关键论证里有一步,本该是-1,写成了1。
就这一个字符。一个"抵消"论证当场失效——本来左右两边会互相抵消,现在不抵了,整个证明塌了。
更要命的是,另外两篇手稿直接建立在这个构造上。Kuga-Satake对应、K3曲面乘积上的有理Hodge猜想,一并撤回。
一个正负号,三条命。
做化工的人对这种死法再熟悉不过:NRTL参数敲反一个负号,塔照样算得风平浪静——直到共沸点对不上。工程错误从来不需要多复杂,只需要够隐蔽。
这722篇,是怎么生出来的
OpenAI在README里写得很坦诚:绝大部分结果出自同一个未发布的内部模型;平均每个结果,烧掉约3小时ChatGPT Pro级别的算力;整个评估过程,给它出了约4000道题。
再往前一个月,同一批人还干过一件更大的事。9月8日,他们宣布"解决"了纳维-斯托克斯方程的存在性与光滑性问题——方向是证明方程的解会"爆破"(blow-up)。这是七大千禧难题之一,克雷研究所悬赏100万美元,挂了26年没人领。
方式是
约一万个AI智能体,连续跑了88个小时
这个方程,化工人从《化工原理》就认识它。管道压降、搅拌功率、换热器流场,追到根上都是它。工程师一百年没解开它,就绕着它活:简化、经验式、数值解。
AI不绕。它直接说:解完了。
3小时,和几个月
把两边的账摆在一起,才有味道:
生成一篇,3小时算力;读懂并确认它没错——按数学圈的经验,几个月起步。
722篇里,约42%(300篇上下)配了Lean形式化证明。Lean可以理解成数学界的"单元测试":证明写成代码,机器逐行核对,每步推导要么过、要么不过,不看作者脸色。这300篇,机器替你把了关。
剩下58%呢?官方README自己写了一句:未经形式化的结果,"可能存在问题",发现即改。
第二天就改了3篇。58%那边的账,还长着。
逐条核对:两份证明对不上
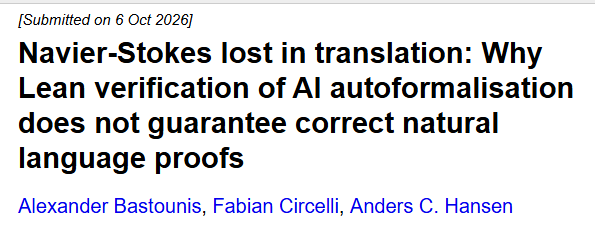
10月6日——就是OpenAI甩出722篇手稿的同一天——剑桥大学与伦敦国王学院的三位研究者,在arXiv上挂出了一份25页的分析。
领衔的是剑桥大学DAMTP的Anders C. Hansen(论文通讯作者),合作者包括同系的Fabian Circelli和伦敦国王学院的Alexander Bastounis。他们盯上的,是9月那份纳维-斯托克斯"证明"。
这份证明有两版:一版自然语言,写给人看;一版Lean代码,写给机器查。注意,Lean那版不是人写的,是AI自己"翻译"过去的。按理说,同一件事的两种写法。
Hansen团队比对发现:在关键引理Lemma 8.6上,自然语言版只需F的m+4阶导数有界,Lean版却写成了m+5——假设更苛刻,所以机器验证通过的那个结论,比人声称的要弱。论文的Remark 3.2标题原话:"Consistent mismatch between m+4 and m+5 derivatives"。
翻译成人话——机器"验证通过"的那个命题,可能不是人类"声称证明"的那个命题。
论文里还有个更狠的结论:让AI忠实地把自然语言翻译成Lean,这个任务的难度,在可解性复杂度指数(Solvability Complexity Index)里是无穷大——比著名的停机问题(SCI = 1)还高。翻译这一步的坑,可能永远填不平。
这笔账算下来也很有味道:OpenAI用88个小时生成证明,Hansen团队花了将近一个月,才人工核对出这一处真正的分歧。
Hansen的原话说得很克制:不是说证明错了,是说这两份,不是一回事。Bastounis在评论里补了一句:OpenAI光顾着炫生成速度,但生成只是整个流程的一半。
"跑通了"和"算对了"之间隔着什么,你比我清楚。
数学家们吵起来了
最有戏剧性的,是人的反应。
复杂性理论学家Dana Moshkovitz,在唯一游戏猜想上做了一辈子。这批结果里,恰好就有一篇声称证明了她的问题。据她丈夫、同为教授的Scott Aaronson在博客里转述,她连夜读完后的短信只有一句:
论文里充斥着混乱的逻辑跳跃,引用堆了一大串,却说不清为什么能用,没有AI辅助根本读不下去。Aaronson为此写了篇博客,标题叫《The Mathocalypse》——数学天启。
帝国理工的Kevin Buzzard没骂。他认认真真翻了722篇里属于自己领域的约30篇,给出质检报告:质量突出的,约7篇;过了Lean验证的,1篇。
一个叫"人类数学协会"(AHM)的组织发了份声明,措辞很硬:"数学家没有要求做这件事。""一次性放出700多个文件,与其说是在做学术,不如说是在展示力量。"最后一句是呼吁:停止与OpenAI合作。
陶哲轩的回应最值得琢磨。他没站队,只说:过去数学拼的是"谁先解出来"——这条赛道,AI一进来就塌了。接下来的价值,会移向"谁真正理解了、谁能判断对错、谁能把结果用起来"。他此前一直警告的事,这次全应验了:AI公司在把数学难题当模型能力基准刷,而"一个问题一旦被宣称解决,就再也回不到未解决的状态"——就算答案错了,它也已经污染了其他可能带来更深刻洞见的研究路径。这种现象可以叫"证明消化不良":证明产出的速度,远超数学家消化的速度。
这事跟你我的关系
把情绪都拿掉,这件事讲的是一笔账:
生成在变得廉价,验证还是昂贵的。
3小时产出一篇手稿的同时,另一头是有人要花几个月逐行去啃——而且这活儿没人抢着干。722篇压在那儿,数学界现在最缺的不是聪明人,是愿意一行一行读完的人。
这套账,换成工艺方案、换成HAZOP报告、换成仿真结果,一模一样。
AI能给你一百个收敛的结果,但"哪个物理上站得住"这个问题,机器暂时替你答不了。
这也是化工人不必慌的地方:我们这个行业,五十年前就把"验收"做成了一整套制度。现在,轮到别的行业补这门课了。
最后聊两句
你验收AI产出的流程是什么?有没有过"看起来都对、其实全错"的翻车经历?评论区说说。